Записки автоматизатора. Профессиональная исповедь.
«Мне так нужна распределенность!».
Хочется обратить внимание читателя на один вопрос, который должен быть решен в самом начале проекта. Это вопрос о том, где хранятся, где обрабатываются и где используются данные. В зависимости от ответа результатом проектирования станут решения, принципиально отличающиеся друг от друга на уровне архитектуры.
Традиционная ошибка, которую разработчики совершают довольно часто, состоит в том, что решение этого вопроса откладывается «на потом» в надежде, что превратить локальную систему в распределенную удастся с помощью небольших модификаций. Я сталкивался с системами, реализованными таким способом, на этапе их сопровождения. Сталкивался очень больно. В системах постоянно появлялась информация, перекореженная в результате активной работы пользователей, разделенных тысячами километров и несколькими часовыми поясами, а я каждый день должен был собирать информационные пазлы, не только рассыпавшиеся, но еще и сломанные в процессе транспортировки, в каждом случае пытаясь понять, в каких местах нашей необъятной Родины и в какой последовательности были нажаты кнопочки и какие скрипты теперь нужно написать, чтобы восстановить сколько-нибудь непротиворечивое состояние системы.
Ситуация с проектированием распределенных систем вдобавок сильно затуманена большим количеством специальных терминов, сильно пугающих неспециалистов, а специалистами трактуемых совершенно по-разному. Поэтому я сначала попытаюсь сформулировать на относительно простом русском языке основные выводы для читателей, для которых специальные слова типа «коллизия», «клинч», «асинхронная репликация» мало что значат, а потом попытаюсь объясниться на специальном жаргоне с более смелыми.
Проще и удобнее всего хранить и обрабатывать информацию в одном месте, а потом передавать ее пользователям (как людям, так и другим информационным системам), расположенным во всех концах земного шара, по каналам связи. В этом случае минимизируется количество ошибок, связанных с одновременными попытками пользователей изменять информацию в системе. На компьютерах пользователей, где бы они ни находились, должно быть установлено только программное обеспечение, позволяющее принимать, отправлять и отображать информацию (программа-клиент). Сейчас появилось много систем, в которых пользователю для начала работы необходимо иметь только обычный интернет-браузер, а необходимые для работы скрипты загружаются по необходимости с сервера (тонкий клиент). Современные каналы связи в большинстве случаев позволяют работать с информационными системами таким способом.
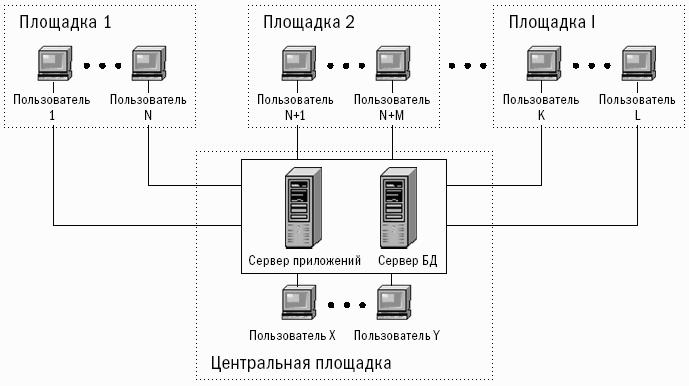
Рис. 7. Пример системы, работающей с удаленными пользователями.
Все остальные способы работы следует использовать только в случае невозможности с нужной скоростью обрабатывать и передавать по каналам связи необходимые объемы информации в течение всего времени функционирования системы.
В гипер-суперсистемах возможны ситуации, когда для хранения и обработки информации не хватает мощностей серверного оборудования, расположенного на одной площадке, но каналы связи обладают достаточной мощностью и надежностью. В таких случаях используются синхронные распределенные системы (иначе – системы с синхронной репликацией). На уровне бизнес-логики распределенность таких систем не видна: как вас не слишком волнует, расположена база на одном диске или на многих, на одном сервере или на многих, так вам не очень важно, расположена база в одном Урюпинске или еще и в Арзамасе. И если пользователь в Арзамасе начал редактировать запись о контрагенте, то другому пользователю из Урюпинска просто придется подождать, поскольку эта запись будет заблокирована.
Собственно, блокировки будут и при использовании централизованной базы данных. Пресловутый онлайн – мечта всех управленцев – означает всего лишь уменьшение задержки при передаче информации. Кстати, если определить, при передаче какой информации нужно минимизировать эти задержки, может выясниться, что это далеко не весь массив данных. Если еще начать выяснять, какова же все-таки максимально допустимая задержка, то может оказаться, что необходимо, например, иметь актуальную информацию об остатках товара один раз в день, а все остальное достаточно обновлять раз в неделю. Так мы приходим уже к периодической репликации.
Конечно же, бывают случаи, когда задержка даже в секунды может дорого стоить (классический пример – биржевая торговля), но чаще всего управленец, требующий непременно данных в режиме реального времени, не будет ими пользоваться чаще одного раза в сутки. И возможно, эти данные ему можно предоставить и более дешевыми средствами, нежели прокладкой каналов до каждого ларька и установкой многомиллионной системы на рабочем месте каждой уборщицы. Понимание этого позволяет значительно сэкономить средства – именно так получаются вполне успешные внедрения маломощных систем в огромных компаниях. – Д. К.
Именно системам с синхронной репликацией посвящено наибольшее количество теоретических работ по распределенным системам. Но такие системы страшно дороги и относительно редки, и, если вы работаете не в корпорации уровня Газпрома, а всего лишь в небольшом холдинге, включающем пару-тройку заводов и сотню магазинов, то вряд ли вам это нужно.
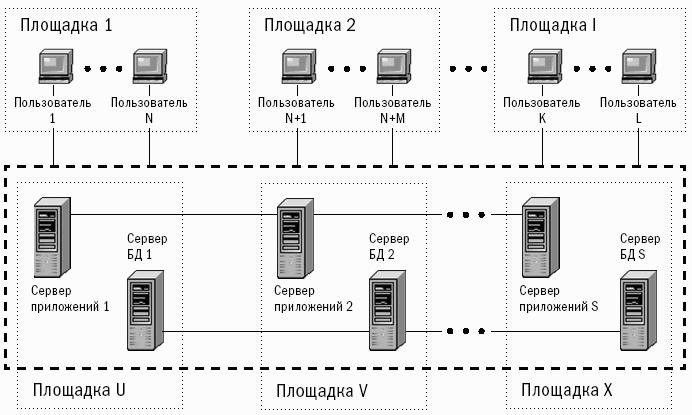
Рис. 8. Пример синхронной распределенной системы.
Основные проблемы с распределенной системой начинаются, когда производительности каналов не хватает, чтобы данные обрабатывались удаленно, а результаты посылались клиентам, или каналы связи не слишком надежны, а с системой нужно продолжать работать на всех площадках, даже когда каналы не работают из-за повышенной солнечной активности, пьяного экскаваторщика, перерубившего кабель, или урагана.
Собственно, не так давно «каналом связи» между двумя площадками в Москве в компании, где я работал, служил курьер, который перевозил винчестер с изменениями базы данных с площадки на площадку два раза в день.
В таких случаях пользователи на каждой площадке работают со своей местной (локальной) базой данных, а сами базы выравниваются или периодически, или когда возникает такая возможность.
Урюпинский пользователь в такой системе может хладнокровно править наименование организации в соответствии с ИНН в тот самый момент, когда арзамасец начнет изменять в своей копии той же записи ИНН организации в соответствии с названием. Эта шутка носит высоконаучное название коллизии. Понятно, что попытка свести воедино арзамасско-урюпинские результаты (то есть разрешить коллизию) вызовет определенные проблемы.
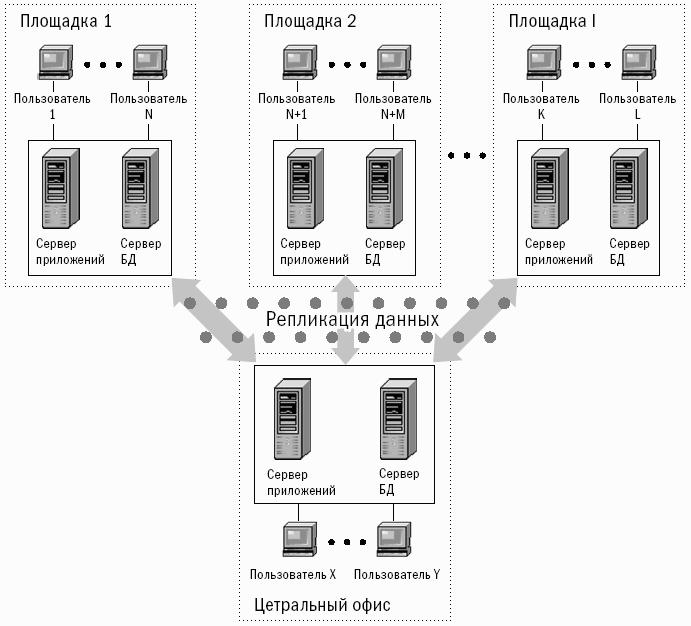
Рис. 9. Пример распределенной системы с асинхронными репликациями.
Такие системы называются системами с асинхронными репликациями, а сам комплект изменений, за один раз передаваемый от одной локальной базы к другой, – репликой. Те, кому не нравится импортное слово «репликация», используют слово «тиражирование», которое почему-то считают более русским. На мой взгляд, больше подходит «выравнивание», но не хочется путать читателя еще больше.
Механизмы корректной работы систем с асинхронными репликациями наиболее сложные, и, как я уже писал, если они не заложены в проект и не продуманы на начальной его стадии, все заканчивается достаточно плохо.
Сейчас любая уважающая себя СУБД имеет встроенные механизмы, которые позволяют организовывать асинхронные репликации и настраивать способы разрешения коллизий. Многие на это ловятся, считая, что «в случае чего» это дает возможность быстро превратить нераспределенную информационную систему в распределенную.
Не тут-то было. Выясняется, что необходимость обмениваться данными нужно было в процессе проектирования держать в голове постоянно, разрабатывая как схему базы, так и способы обработки данных.
Например, из реплицируемой базы данных ничего нельзя удалять физически, поскольку после этого вы потеряете и информацию о том, что нужно удалить из других локальных баз. Если вы так поступали, то это придется поменять.
Очень интересно получится, когда сервера системы начнут функционировать в разных часовых поясах. Конечно, СУБД при репликации позаботится о модификации временных меток, которые она сама установила, но как работать с другими датами и временами, записанными в базе, вам было бы неплохо заранее разобраться самому, чтобы потом не гадать, глядя на 0:00, была в этот момент полночь в Москве или в Петропавловске-Камчатском.
Самые большие проблемы могут возникнуть при передаче взаимосвязанной информации, поскольку в принимающей базе в общем случае этой информацией можно пользоваться только после того, как в нее попадут все взаимозависимые записи.
Пример. Пусть по каким-то причинам вы храните фамилию в одной таблице базы, а имя и отчество – в другой, ссылающейся на первую. В Урюпинске оператор заполнил форму, в которой указал Орлв Андрей Георгиевич. С помощью репликаций эта информация должна оказаться в Арзамасе. Реплики отправляются по расписанию, объем одной реплики ограничен. Поэтому в Арзамас в первой реплике пришла только фамилия из главной таблицы. Оператор в Арзамасе увидел ошибку в фамилии и исправил ее. Теперь в Арзамасе в главной таблице «Орлов», а в зависимой еще пусто. Наконец со следующей репликой в Арзамас приходит запись, в которой указано «Андрей Георгиевич». Но в базу она не попадет: главная запись уже была изменена, и процедура автоматического разрешения коллизий «Андрея Георгиевича» отвергнет.
Если же вы еще и не все зависимости описали на уровне СУБД, а поддерживаете какие-то из них с помощью алгоритмов обработки, то становится совсем загадочным, как это все собрать на принимающем конце.
А поскольку многие системы стараются поддерживать несколько СУБД, то вероятность использования механизмов приложения, а не СУБД в них достаточно велика, что делает репликацию средствами СУБД достаточно сложной. – Д. К.
Арсенал средств обработки в современных СУБД весьма внушителен, все они полезны в каких-то случаях, но желание разработчика использовать все эти средства сразу может приводить к результатам слабо предсказуемым. А ведь часто данные в нескольких зависимых записях сначала изменяются хранимой процедурой, в работу которой вклиниваются несколько триггеров, после чего результат полируется заданием (джобом), который запускается каждые пять минут, а посреди всего этого отрабатывает репликация, а потом нечто похожее происходит и в базе-приемнике…
Продолжать скорбный список можно достаточно долго, но я надеюсь, что основную мысль я все-таки донес: попытка превратить неплохо работающую систему с нераспределенной базой в распределенную систему может привести к необходимости делать проект сначала.
Еще немного про коллизии, то есть про независимое изменение одних и тех же данных на разных площадках. При репликации они должны быть разрешены, а значит, из двух вариантов изменения должен быть выбран только один или отброшены оба изменения.
Коллизия – это в любом случае плохо. Разрешение коллизии, каким бы способом оно ни производилось (по времени изменения записи, по приоритету площадки или пользователя, администратором системы вручную после необходимых телефонных звонков), означает, что вы похоронили чью-то работу.
Поэтому основные усилия на начальной стадии проекта, безусловно, надо направить на попытки устранения коллизий регламентным путем, разделив места создания и изменения информации или хотя бы время таких действий.
Коллизий не будет, если вам удастся организовать работу так, чтобы на разных площадках изменялись разные типы объектов. Проблем не будет, если номенклатуру и контрагентов добавлять только в центральном офисе, а использовать на всех площадках.
Несколько хуже, когда на разных площадках изменяются разные объекты одного типа, различаемые по какому-то признаку. Хуже потому, что этот признак тоже можно на какой-то площадке изменять. То есть формирование приходных и расходных накладных на один и тот же товар не доставит вам проблем, поскольку пара «Получатель» и «Отправитель» в таких накладных будет для каждой площадки разной, а вот с информацией о клиентах, приписанных к точкам обслуживания, работать будет хуже, поскольку клиенты любят менять точки обслуживания, и если вы отбирали клиентов для репликации по этому признаку, то неплохо понять заранее, где именно разрешить изменять этот признак и как будет происходить репликация измененной записи.
Для банковских и кассовых документов больше подходит регламентное разделение времени изменения документов. Например, три дня их можно изменять только на площадке, где они введены, а начиная с четвертого дня – только в центральном офисе.
Только вот отнюдь не всегда удается организовать работу так, чтобы это было удобно проектировщику информационной системы. Если руководство компании решит, что клиента можно обслуживать любым способом на любой площадке, вам придется поломать голову, как с наименьшим ущербом именно так и сделать.
Очень жаль, что в техническом задании не принято писать «Программа должна работать»…
Единственный общий совет этого раздела: старайтесь не экономить время на этапе постановки (написания технического задания). Реально это единственный этап, на котором время вам выделено именно для того, чтобы вы думали – дальше нужно будет трясти. Правда, руководство и на этом этапе требует сверхскоростей. Ведь для него хуже нет, чем вот уже два месяца платить зарплату и не иметь с этого не только никакого барыша, но даже хотя бы какого-то видимого результата. Однажды на очередной покрик «Давай-давай!!!» я отыскал в Интернете, распечатал и раздал всем генерально-исполнительным начало первой главы «Винни-Пуха»:
«Ну вот, перед вами Винни-Пух.
Как видите, он спускается по лестнице вслед за своим другом Кристофером Робином, головой вниз, пересчитывая ступеньки собственным затылком: бум-бум-бум. Другого способа сходить с лестницы он пока не знает. Иногда ему, правда, кажется, что можно бы найти какой-то другой способ, если бы он только мог на минутку перестать бумкать и как следует сосредоточиться. Но увы – сосредоточиться-то ему и некогда».
Алан Александр Милн «Винни-Пух И Все-Все-Все» (Пересказ Б. Заходера).Авторитет Милна на время подействовал.